


Pierwsze realizacje mechanizmu watchdoga były proste – w praktyce jest to timer, który generuje sygnał błędu w razie przepełnienia swojego licznika, o ile ten wcześniej nie zostanie zewnętrznie zresetowany. Z czasem jednak ewoluowały i stopień ich komplikacji rósł w miarę, jak zwiększała się złożoność aplikacji i zaostrzano wymagania norm z zakresu bezpieczeństwa funkcjonalnego.
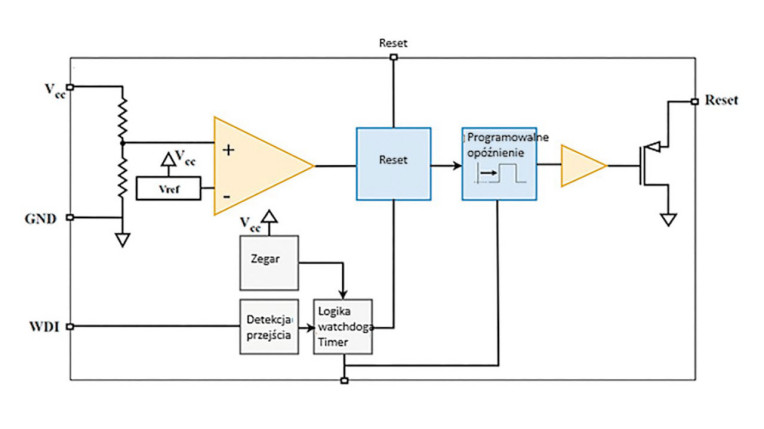
W podstawowej wersji funkcję watchdoga dla głównego procesora można zrealizować w układzie ASIC. Przykład takiego układu przedstawiono na rys. 1. Ze względu na prostotę może także zostać zintegrowany bezpośrednio w procesorze. Zwykle blok watchdoga wykorzystuje wejście GPIO do detekcji, czy procesor działa. Jeżeli sygnał resetu licznika nie zostanie odebrany w zdefiniowanym odstępie czasu i nastąpi jego przepełnienie, zgłaszany jest błąd. Dla tego typu bloków funkcyjnych wbudowanych w procesor można zwykle, korzystając z rejestrów funkcji specjalnych SFR (Special Function Registers), skonfigurować podstawowe parametry pracy. Są to: typ wyzwalania (zboczem narastającym, opadającym), limit czasu (interwał resetowania licznika) oraz opóźnienie resetu, czyli czas, jaki upływa od momentu przepełnienia się licznika watchdoga, do chwili zgłoszenia błędu. Przeważnie ustawiany jest maksymalny interwał, odpowiadający najdłuższemu czasowi wykonania operacji jednostkowej albo czasowi, przy którym aplikacja jeszcze pozostaje odporna na błędy, z zachowaniem odpowiedniego marginesu bezpieczeństwa. Taka realizacja mechanizmu watchdoga, oprócz prostoty, ma kluczową wadę. Chociaż zapewnia wykrywanie kompletnego zawieszenia się systemu, nie pozwala na sprawdzanie, czy poszczególne zadania są wykonywane w zakładanych ramach czasowych.
Watchdog okienkowy
Potrzeba detekcji nietypowych czasów realizacji operacji doprowadziła do rozwoju watchdogów okienkowych (window watchdog). Monitorują one wystąpienie sygnału kontrolnego w określonym, akceptowalnym w danym zastosowaniu, okienku czasowym. Wyjaśniono to na rysunku 2. Można na nim wyróżnić trzy krytyczne, konfigurowalne, limity czasowe: dolny, górny i ostateczny. Jeżeli sygnał kontrolny dotrze w czasie krótszym niż dolny limit, watchdog zasygnalizuje błąd. Podobnie jak wówczas, gdy spóźni się, docierając, kiedy już minie czas wyznaczany przez górny limit. Jeżeli po upływie ostatecznego limitu sygnał kontrolny nie zostanie odebrany, mikrokontroler zostanie zresetowany, ponieważ będzie to oznaczało całkowity brak reakcji, tak jak w podstawowej wersji watchdoga. Zazwyczaj w watchdogach okienkowych skonfigurować można trzy wymienione limity czasowe i tolerancję błędów, czyli ich liczbę, po przekroczeniu której aktywowany jest reset.
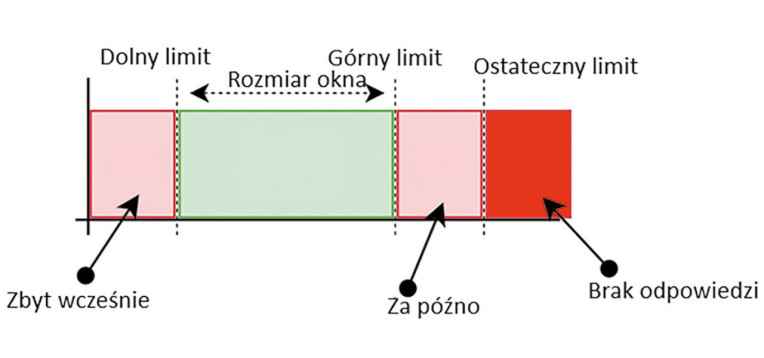
Dzięki wyznaczeniu zarówno dolnego, jak i górnego ograniczenia czasowego, watchdog okienkowy zapewnia dwie kluczowe korzyści. Przede wszystkim pozwala na skonfigurowanie różnych reakcji systemu w zależności od tego, czy sygnał kontrolny został wysłany za wcześnie, czy zbyt późno. Na przykład można go tak zaprogramować, żeby tolerował drobne naruszenia czasowe i kontynuował wykonywanie programu pomimo ich wystąpienia w rozsądnych granicach. Oprócz tego można zaimplementować mechanizm śledzenia przekroczeń limitów czasowych i ich odnotowywania w rejestrze, który później poddaje się analizie pod kątem wyszukania zadań, które najczęściej były kończone przedwcześnie lub przedłużały się. Pomaga to diagnozować wąskie gardła wydajności lub awarie komponentów. Z drugiej strony, mimo że watchdog okienkowy wykrywa operacje trwające za długo i za krótko, nie sprawdza poprawności ich wykonania. Taką możliwość zapewnia bardziej zaawansowany mechanizm watchdoga typu wyzwanie – odpowiedź (challenge – response), inaczej Q&A (question and answer).
Watchdog Q&A
Watchdogi wyzwanie – odpowiedź wykorzystywane są w aplikacjach wymagających najwyższego poziomu bezpieczeństwa. Także opierają się na koncepcji okna czasowego, weryfikują jednak nie tylko to, czy mikrokontroler reaguje we właściwym czasie, ale czy jego odpowiedź jest prawidłowa. W tym podejściu watchdog wysyła wyzwania (pytania), które monitorowany procesor powinien przetworzyć zanim zwróci wynik. W tym celu wykonuje obliczenia arytmetyczne albo operacje bitowe. Watchdog na podstawie konkretnych, napływających sekwencyjnie odpowiedzi może sprawdzić, czy system uruchamia właściwy kod we właściwej kolejności i bezbłędnie. Spotyka się różne warianty realizacji mechanizmu wyzwanie – odpowiedź.
Przykładowo watchdog wysyła kilka niezależnych, sekwencyjnych wyzwań, a na każde z nich musi zostać udzielona poprawna odpowiedź w odpowiednim oknie czasowym. W tym celu procesor musi na przykład wykonać proste operacje na wartości 8-bitowej, jak: ustawienie bitów parzystych na 0, odwrócenie wartości bitów nieparzystych, odwrócenie wszystkich bitów. Wykorzystuje się również sekwencje wyzwań, dla których prawidłowe odpowiedzi są ze sobą powiązane.
Watchdogi wyzwanie – odpowiedź implementowane są m.in. w zaawansowanych układach ASIC, układach nadzorujących napięcie (voltage supervisor) czy PMIC (Power Management Integrated Circuit), w których wykorzystuje się interfejsy, jak I²C lub SPI do wysyłania wyzwań oraz odbioru odpowiedzi. Podejście Q&A zapewnia większą skuteczność weryfikacji, pozwalając na sprawdzanie poprawności kolejności przepływu zadań w programie i wdrożenie zaawansowanych mechanizmów obsługi błędów, na przykład śledzenia wyzwań, które zostały pominięte albo na które udzielono nieprawidłowej odpowiedzi. Dzięki temu system może płynniej reagować, ignorując drobne usterki, a twardy reset wyzwalając jedynie w naprawdę uzasadnionych przypadkach. Dalej przedstawiamy przykłady układów z funkcją watchdogów różnych typów.
Przykład - MIC826
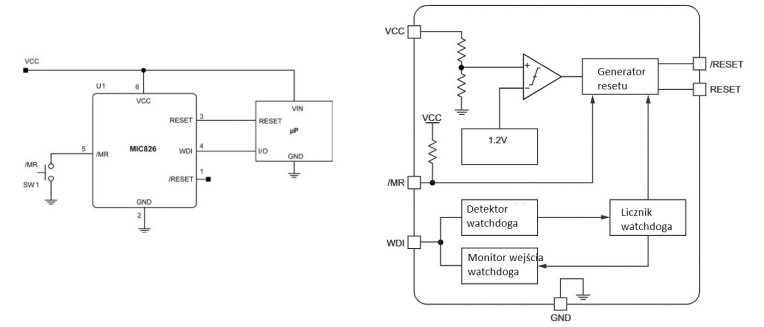
MIC826 to monitor napięcia z wejściem resetu ręcznego, wejściem watchdoga i dwoma wyjściami resetu. Układ generuje i utrzymuje reset, gdy napięcie zasilania spadnie poniżej zaprogramowanego progu, gdy na wejściu /MR jest stan niski albo gdy licznik watchdoga wskaże przekroczenie limitu czasu. Układ MIC826 ma aktywne w stanie niskim wyjście /reset i aktywne w stanie wysokim wyjście reset. Oba wyjścia są typu push-pull, co eliminuje potrzebę stosowania rezystorów pull-up. Na wejściu /MR wbudowano rezystory pull-up 52 kΩ, co ułatwia podłączenie przycisku. Układ MIC826 ma również wejście watchdoga WDI (rys. 3).
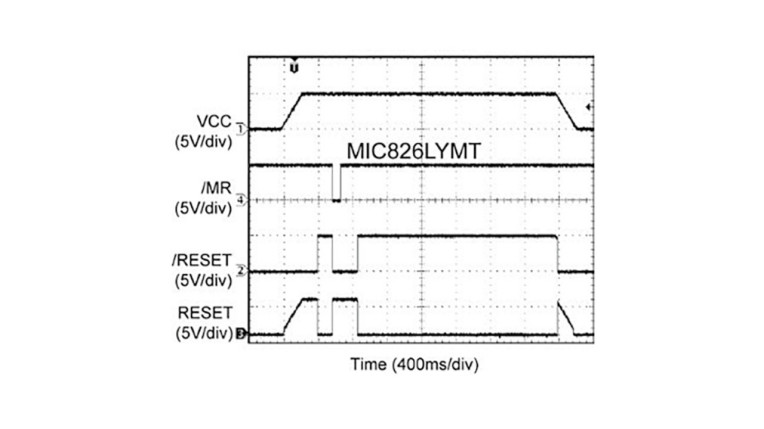
W przypadku ręcznego resetu wyjścia /reset i reset są aktywne, jeżeli pin /MR jest w stanie niskim. Oba wyjścia resetu pozostają aktywne przez zaprogramowany czas opóźnienia resetu, tRP, który wynosi 200 ms. Wyjście /reset jest w stanie niskim, a reset w stanie wysokim, jeżeli wejście /MR jest w stanie niskim (rys. 4).
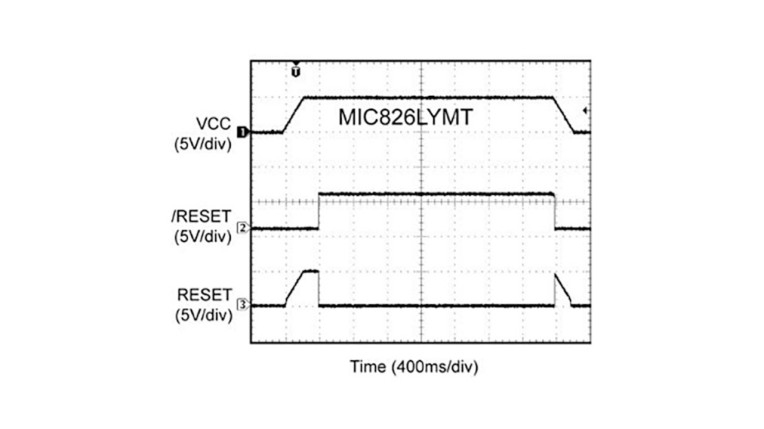
Podczas pracy jako monitor napięcia (rys. 5) wyjście /reset jest aktywne, jeżeli napięcie zasilania spadnie poniżej progu napięcia resetowania VRST. Wejście do podłączenia napięcia uwzględnia histerezę, aby zapobiec drganiom wyjść /reset albo reset spowodowanych szumem. Wyjście /reset pozostaje aktywne przez czas opóźnienia resetowania tRP po wzroście napięcia zasilania powyżej progu napięcia resetowania powiększonego o histerezę. Funkcja ta zapewnia prawidłowe zresetowanie procesora i jego uruchomienie w znanym stanie po awarii zasilania. Wyjście /reset pozostaje aktywne nawet przy napięciu zasilania tak niskim, jak 1 V. Analogicznie działa wyjście reset.
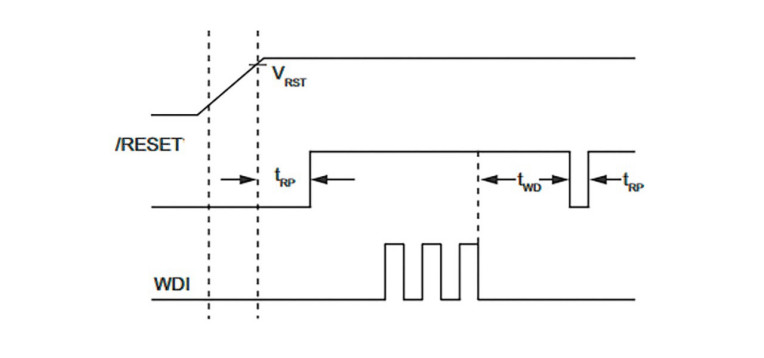
MIC826 ma wbudowany watchdog (rys. 6), który może zresetować procesor, jeśli ten nie przełączy wejścia WDI w ustalonym czasie tWD. Jeśli wejście WDI pozostanie niepodłączone, funkcja ta jest wyłączona. Watchdog zaczyna odmierzać czas, jak tylko którekolwiek z wyjść resetujących staje się nieaktywne i gdy przed upływem czasu tWD nastąpi przełączenie ze stanu wysokiego na niski lub z niskiego na wysoki. W przypadku przepełnienia licznika, wyjścia resetujące zostają aktywowane i pozostają aktywne przez czas resetowania tRP. Licznik jest również zerowany za każdym razem, gdy wyjścia resetujące zostaną aktywowane przez reset ręczny /MR lub gdy napięcie zasilania spadnie poniżej VRST.
Przykład - TPS3852
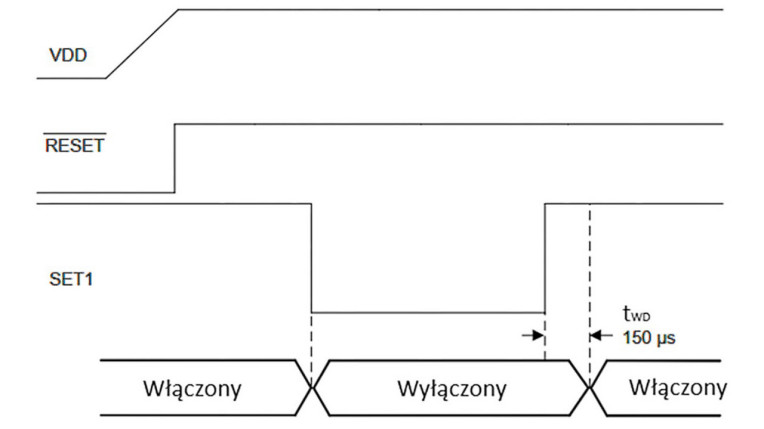
TPS3852 to monitor napięcia z wbudowanym programowalnym watchdogiem okienkowym (rys. 7). Aktywowanie tej funkcjonalności następuje za pośrednictwem wejścia SET1. Jeżeli jest w stanie niskim, watchdog jest wyłączony, a sygnał na wejściu WDI jest ignorowany. Wyjście WDO będzie wówczas w stanie wysokiej impedancji. Gdy wejście SET1 jest w stanie wysokim, watchdog działa. Stan tego wejścia można zmieniać dowolnie. Można także skonfigurować czas tWD, przez który po włączeniu watchdog chwilowo nie reaguje na zmiany sygnału WDI (rys. 8).
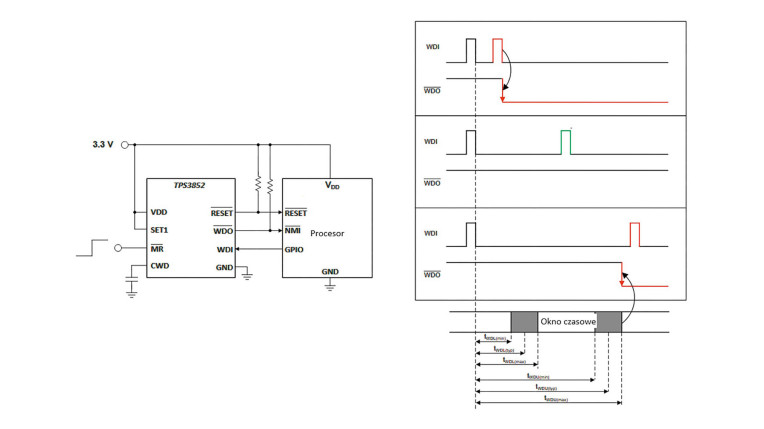
WDI to wejście watchdoga, które steruje jego wyjściem WDO umożliwiającym sygnalizowanie błędów w synchronizacji, bez konieczności resetowania procesora. WDI jest wyzwalane opadającym zboczem sygnału wejściowego. Pierwszy impuls powinien zostać wygenerowany przed tWDU(min). Po nim, żeby uniknąć resetu, monitorowany procesor powinien wygenerować impuls WDI w oknie czasowym ograniczonym przez tWDL(max) i tWDU(min). Jeżeli impuls zostanie wygenerowany w tym przedziale, stan wyjścia WDO się nie zmienia. W przeciwnym razie przechodzi ono w stan niskiej impedancji. WDI to wejście cyfrowe, dlatego zawsze musi być podłączone do masy albo napięcia zasilnia. Podanie na nie napięcia pośredniego może spowodować wzrost poboru prądu ze względu na jego konstrukcję na poziomie bramek logicznych. Po wygenerowaniu sygnału reset watchdog zostaje wyłączony, a wszystkie sygnały na wejściu WDI są ignorowane.
W TPS3852 przewidziano trzy opcje ustawienia szerokości okna czasowego: przez podłączenie kondensatora do wejścia CWD, podłączenie tego wejścia do zasilania przez rezystor pull-up albo jego niepodłączanie w ogóle. Jeżeli wejście CWD zostanie podłączone do napięcia zasilania przez rezystor pull-up 10 kΩ lub pozostaje niepodłączone (w stanie wysokiej impedancja), wtedy aktywne są fabrycznie zaprogramowane ustawienia okna czasowego. Jeśli jednak do CWD podłączony jest kondensator, wówczas źródło prądu o natężeniu 375 nA ładuje go do wartości VCWD = 1,21 V. Górną granicę okna czasowego można obliczyć ze wzoru tWDU(typ)(s) = 77,4 · CCWD(μF) + 0,055 (s). Dopuszczalne jest podłączanie wyłącznie kondensatorów CCWD o pojemności od 100 pF do 1 μF. Przy pojemności 100 pF górna granica okna czasowego wynosi 62,74 ms, a przy 1 μF jest równa 77,455 s.
Przykład - TCAN114x
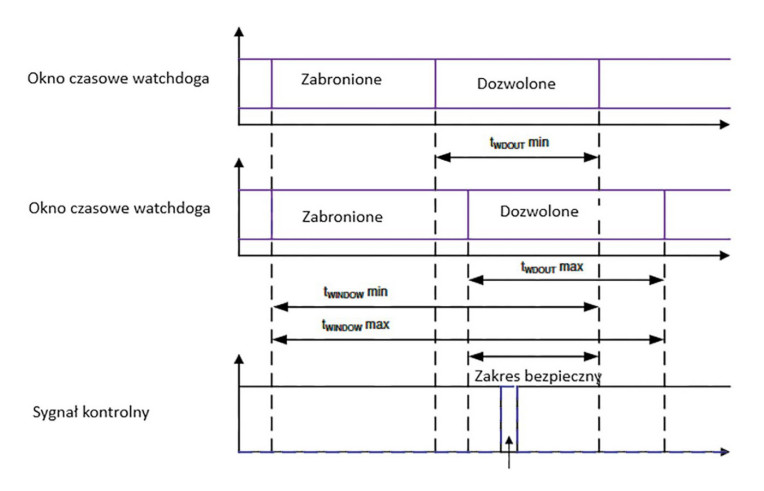
TCAN114x to transceiver CAN z wbudowanymi watchdogami trzech rodzajów: przepełnienia licznika, okienkowym i wyzwanie – odpowiedź. Jeżeli chodzi o ten drugi, pod uwagę trzeba wziąć to, że jest skonfigurowany z częścią otwartą i zamkniętą okna czasowego w proporcji 50% – 50%, a dokładność wewnętrznego zegara wynosi ± 10%. By określić, kiedy powinno się podać sygnał kontrolny, należy wziąć pod uwagę to ograniczenie precyzji układu taktującego. Przykładowo, przy oknie czasowym 60 ms, podział na połowę oznacza szczeliny po 30 ms. Uwzględniając jednak to, że tolerancja wewnętrznego zegara wynosi ± 10%, trzeba przyjąć, że okno czasowe trwa 54 ms (tWINDOW, MIN, co pokazano na rys. 9) albo 66 ms (tWINDOW MAX). Szczeliny wynosiłoby wtedy 27 ms (tWDOUT,MIN) lub 33 ms, (tWDOUT, MIN). Przy oknie czasowym 54 ms i szczelinie, w której transmisja sygnału kontrolnego jest zabroniona równej 33 ms, zmieścić go trzeba w 21 ms. Bezpieczny przedział w związku z tym to 43,5 ms ± 10,5 ms.
Watchdog w TCAN114x może również pracować w trybie Q&A. Monitorowany mikrokontroler odczytuje wtedy pytanie, na jego podstawie wykonuje obliczenia i przesyła ich wyniki z powrotem do TCAN114x. Poprawna odpowiedź składa się z czterech bajtów. Każdy bajt musi zostać zapisany we właściwej kolejności i w odpowiednim oknie czasowym, by odpowiedź uznano za prawidłową. Wyróżnia się dwa okna czasowe: dla odpowiedzi nr 1 i odpowiedzi nr 2, oba o szerokości 50% całkowitego czasu cyklu. Każde pytanie i odpowiedź składają się na pełen cykl.
Po odczytaniu pytania przez mikrokontroler uruchamia się licznik watchdoga. Mikrokontroler musi wykonać funkcję matematyczną na pytaniu, której wynikiem są cztery bajty odpowiedzi. Trzy z nich muszą zostać zapisane do rejestru odpowiedzi w pierwszym oknie, w poprawnej kolejności. Ostatni jest zapisywany do rejestru odpowiedzi w oknie odpowiedzi nr 2. Jeśli wszystkie cztery bajty są poprawne i w prawidłowym porządku, odpowiedź zostaje zaakceptowana i generowane jest nowe pytanie, co rozpoczyna cały cykl od początku. Jeśli którakolwiek z odpowiedzi częściowych jest niepoprawna lub została pominięta, całą odpowiedź uznaje się za błędną. Pytanie kontrolne nie ulega wówczas zmianie, a licznik błędów zostaje zwiększony. Gdy osiągnie wartość progową, generowane jest przerwanie lub aktywowany jest reset, w zależności od ustawień.
Watchdogi w praktyce
Wybór konkretnego typu watchdoga zależy od specyfiki aplikacji, jej wymogów wydajności oraz tolerancji na awarie. Przed podjęciem decyzji trzeba przeanalizować możliwe typy błędów, które powinien wykrywać oraz ich wpływ na bezpieczeństwo aplikacji, jak również zasoby sprzętowe i programowe, które watchdog będzie ewentualnie współdzielić z mikrokontrolerem, żeby uniknąć niepożądanych zależności mogących wpływać na skuteczność detekcji awarii. Ponadto mechanizmy zgłaszania błędów przez watchdoga powinny być adekwatne do potrzeb aplikacji – przykładowo czasem konieczne jest, by watchdog rozróżniał różne przyczyny resetu.
Jeśli chodzi o typy błędów, to wyróżnić można ich dwie kategorie: losowe, których wystąpienia nie można przewidzieć i nieprzypadkowe. Do pierwszych zalicza się usterki sprzętowe, na przykład uszkodzenie zegara systemowego, bądź zaburzenia zewnętrzne, które zakłócają działanie układów taktowania, wpływając m.in. na ciągłość transmisję danych. W drugim przypadku zadania mogą nie być wykonywane poprawnie albo wywoływać zawieszanie się systemu na przykład przez błędy w kodzie, jak nieprawidłowe odwołania do pamięci. Analiza możliwych typów awarii pozwala podjąć świadomą decyzję o tym, czy wybrać prosty watchdog okienkowy czy typu wyzwanie – odpowiedź, o większych możliwościach, jak weryfikacja poprawności operacji arytmetycznych, monitorowanie poszczególnych rdzeni w architekturze wielordzeniowej czy detekcja nieregularności częstotliwości taktowania.
Kluczowe jest też to, by watchdoga nie dotyczyły zależności mogące uniemożliwić mu wykrywanie błędów. Takim są współdzielone zasoby, które mogą ulec awarii. Przykładami są: korzystanie przez rdzeń procesora, watchdog i urządzenia peryferyjne z jednego zegara lub współdzielenie pamięci i zasilania.
Jeśli wykorzystywanych jest kilka watchdogów kluczowe znaczenie ma organizacja ich współpracy. Można wprowadzić hierarchię, rozróżniając dwie kategorie: watchdogi podrzędne, oddzielne dla każdego rdzenia i nadrzędne, zewnętrzne, na przykład w układzie PMIC albo monitorze napięcia. Zapewnia to niezależność na kilku poziomach. Przede wszystkim zewnętrzny watchdog nadrzędny korzysta z własnego źródła zegara. Jeśli więc zegar któregoś z rdzeni ulegnie awarii, co dezaktywuje jego watchdoga, watchdog nadrzędny to wykryje. Poza tym można wówczas odizolować błędy. W praktyce oznacza to, że każdy podrzędny watchdog może wywołać lokalny reset lub przerwanie dla swojego rdzenia. Jeśli jednak to się nie powiedzie, nadrzędny watchdog podejmuje dalsze działania.
Monika Jaworowska


